引言:
欢迎来到机器学习的世界
机器学习(ML)是现代计算机科学中最令人兴奋的领域之一。
从自然语言处理和垃圾邮件过滤器,到图像识别、计算机视觉、推荐系统、自动驾驶汽车、农业和医学,机器学习无处不在。
本课程不仅涵盖机器学习的前沿理论,还强调动手实践。通过亲自实现算法,你将深入理解其内部机制。这至关重要,因为仅仅掌握算法和数学知识并不足以解决实际问题。
机器学习的流行源于它突破了传统编程的局限。对于网页搜索和照片标注等复杂任务,我们无法直接编写固定程序来实现预期效果。相反,机器学习使计算机能够从数据中自主学习解决方案。如今,机器学习已广泛应用于数据库挖掘、病历分析、计算生物学和无人直升机控制等众多领域,市场需求远超专业人才的供给。
学习机器学习不仅仅是学习公式和算法,还包括:
- 理解哪些问题适合用机器学习解决
- 知道如何选择模型和方法
- 能够在实践中实现和调优算法
什么是机器学习?
两个经典定义:
1.Arthur Samuel(1950年代):
研究领域:使计算机能够在无需显式编程的情况下具备学习能力。
他编写了一个国际象棋程序,让程序与自己对弈;经过数千局的自我对弈,该程序的水平超越了其创造者。
2.Tom Mitchell(现代定义):
如果一个计算机程序在某类任务 T 上的性能(以 P 衡量)随着经验 E 的积累而提升,则称该程序从经验 E 中学习。
记忆公式:T(E)ₚ - 通过经验 E 提升任务 T 在指标 P 上的表现
示例:垃圾邮件过滤器
- T(任务):将邮件分类为垃圾邮件或非垃圾邮件
- E(经验):用户标记为垃圾邮件的样本
- P(性能):正确识别垃圾邮件的概率
简单来说:
👉 我们不硬编码规则,而是让机器从数据中学习模式。
为什么需要机器学习?
因为对于许多复杂问题:
- ❌ 很难编写明确的规则
- ✅ 但我们通常有大量数据可供学习
监督学习
监督学习是指训练数据集中的每个样本都附带”正确答案”(标签)。算法学习样本特征与标签之间的映射关系,从而实现对未知样本的预测。
特征:
- 训练数据包括输入
x和正确输出y - 目标是学习从
x → y的映射
形式:(x, y)
两大主要类型:
- ✅ 回归问题 - 预测连续值
例如:
- 房价
- 温度
- 销售额
1
2
3
4
示例:房价预测
输入:房屋面积(750平方英尺)
输出:预测价格($150,000)
特点:输出为连续数值,可取任意实数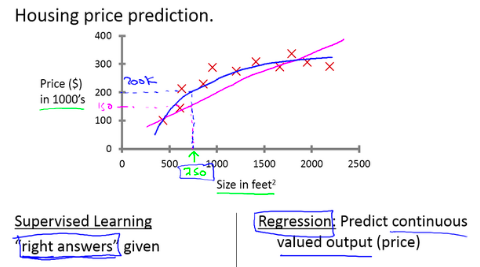
- ✅ 分类问题 - 预测离散类别
例如:
- 垃圾邮件 / 非垃圾邮件
- 患病 / 健康
- 图像类别
1
2
3
4
示例:肿瘤诊断
输入:肿瘤特征(大小、密度等)
输出:良性(0) / 恶性(1)
特点:输出为有限离散值集合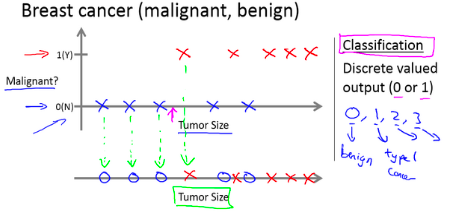
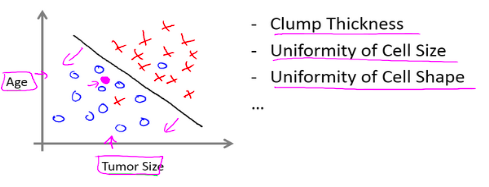
监督学习的本质:
从带标签的数据中学习,使模型能够对新样本做出预测。
无监督学习
无监督学习与监督学习的核心区别在于训练数据没有标签。算法需要自主发现数据中的潜在结构。无监督学习的典型代表是聚类算法。
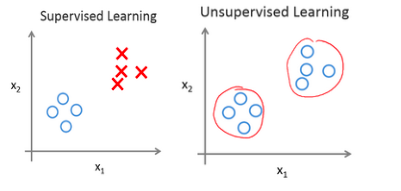
特征:
- 只有输入数据 x
- 没有标签 y
- 目标是发现数据中的结构
常见任务:聚类
- 应用:
- 自动对新闻进行分组(如 Google News)
- 客户细分
- 基因分析
- 社交网络中的社区发现
- 鸡尾酒会问题:
matlab:
1 | % Audio separation achieved with just one line of code |
- 从混合声音中分离不同说话者的音频
- 展示了使用合适工具的重要性
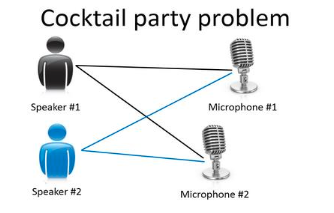
直观理解:我们事先不知道类别,但希望算法自行发现相似的群组。
对比:
| 数据有标签? | 有标签? | 目标 |
|---|---|---|
| 监督学习 | 是 | 预测 |
| 无监督学习 | 否 | 发现结构 |
单变量线性回归
模型表示
单变量线性回归是一个入门级的机器学习算法,用于解决单特征回归问题(例如,用房屋面积预测房价)。
让我们从一个例子开始:这个例子是关于预测房价的,我们将使用一个包含俄勒冈州波特兰市房价的数据集。在这里,我将根据不同的房屋面积和对应的售出价格绘制我们的数据集。
例如,如果你朋友的房子面积为1250平方英尺,你想告诉他们能卖多少钱。你可以做的事情之一就是建立一个模型——比如一条直线——从这个模型中,你可以告诉你朋友这套房子大约能卖22万美元。
这是一个监督学习算法的例子。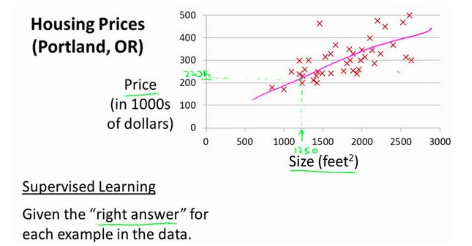
训练集: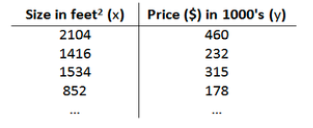
符号说明:
- m:训练样本数量
- x:特征
- y:目标值
- (x⁽ⁱ⁾, y⁽ⁱ⁾):第 i 个训练样本
- h(x):假设函数(模型),用于预测 y 的值
单变量线性回归模型:1
hθ(x) = θ₀ + θ₁ x
这是一条直线,其中:
θ₀是截距,即假设函数与 y 轴的交点θ₁是斜率,表示特征 x 对目标 y 的影响程度
目标:
找到 θ₀ 和 θ₁,使得这条直线尽可能好地拟合数据。
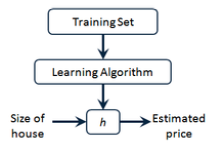
代价函数
为了衡量假设函数的预测误差,我们需要定义一个代价函数(Cost Function),它主要计算预测值与实际值之间的误差平方和。
代价函数的定义
单变量线性回归使用均方误差(MSE)作为代价函数,定义公式如下:
1 | J(θ₀, θ₁) = (1 / 2m) * Σ (hθ(x⁽ⁱ⁾) - y⁽ⁱ⁾)² |
- 1/2:求导时与平方项的系数约去,简化计算
- Σ (hθ(x⁽ⁱ⁾) - y⁽ⁱ⁾)²:所有样本的预测误差平方和
- J(θ₀, θ₁): 代价函数的值越小,说明模型的预测精度越高
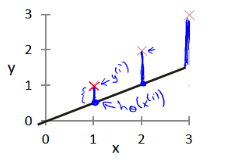
含义:
将误差平方
对所有训练样本求平均
越小越好
👉 我们的目标:
1 | minimize J(θ₀, θ₁) |
为什么选择平方误差?
- 数学上:便于求导,优化更平滑
这是首要原因。
平方函数 (y-ŷ)² 在任意点上都是光滑的凸函数,其导数为 2(y-ŷ),非常简洁。
绝对值函数 |y-ŷ| 在 y=ŷ 处不可导(存在”尖点”)。这会导致梯度下降等基于梯度的优化算法在该点”卡住”,需要特殊处理。
直观类比:
平方误差就像一个光滑的碗形曲线——一个球(优化过程)可以平滑地滚到碗底(最小值)。
绝对值误差就像一张折成 V 形的纸,中间有一条尖锐的折痕——球滚到尖端时会卡住,不知道该往哪个方向滚。
统计上:符合最大似然估计的假设
当我们假设数据误差服从正态(高斯)分布时,最大化似然函数等价于最小化均方误差。这是许多线性模型的统计学基础。由于正态分布在自然界中很常见,这个假设通常是合理的。效果上:对大误差施加更重的惩罚,对异常值更敏感
误差² 会放大大误差的影响。
- 优点:模型会尽力避免大的预测错误,因为代价随误差呈二次增长。这通常是我们期望的行为。
- 缺点:如果数据中存在异常值,平方会放大其影响,可能将模型”带偏”。(此时可以使用绝对值误差或 Huber 损失来缓解。)
示例:
误差 = 1 → 平方代价 = 1
误差 = 2 → 平方代价 = 4(误差翻倍,代价变为4倍)
误差 = 10 → 平方代价 = 100(误差变为10倍,代价变为100倍)
- 良好的数学性质(凸函数,存在唯一最小值)
- 对大误差施加重惩罚
- 在实际应用中表现良好
代价函数的直观理解(一)
想象不同的直线:
有些远离数据 → 误差大 → J 大
有些很好地拟合数据 → 误差小 → J 小
所以 J 告诉我们:
👉 平均而言,这条直线拟合数据的程度有多差。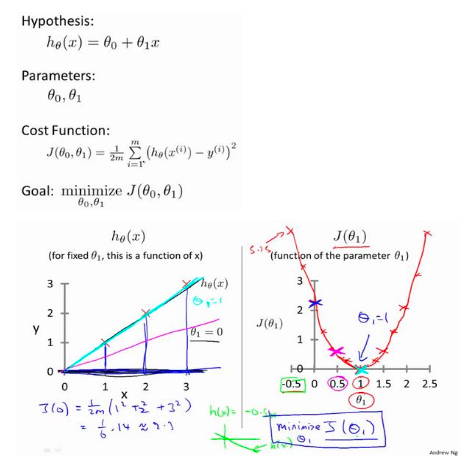
代价函数的直观理解(二):等高线图
如果我们把 θ₀ 和 θ₁ 作为坐标轴,J(θ₀, θ₁) 作为高度:
- 我们会得到一个碗形曲面
- 最低点对应最优参数
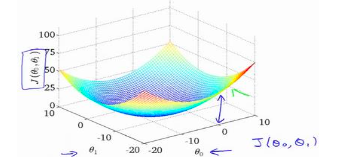
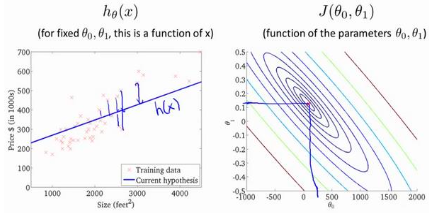
等高线图显示:
- 每条闭合曲线上的 J 值相同
- 越往内层,J 值越小
👉 学习的过程就像:
在误差地形上不断下坡,直到到达最低点。
梯度下降
梯度下降是一种用于最小化函数的通用算法。
核心思想:
从一个随机点出发,沿着最陡的下坡方向迈出一小步,不断重复直到到达谷底
步骤:
- 从某个初始点 (θ₀, θ₁) 开始
- 沿着 J 下降最快的方向迈出一小步
- 重复直到收敛
更新规则:1
θⱼ := θⱼ - α * ∂J(θ) / ∂θⱼ
其中:
- α 是学习率(步长)
- := 表示赋值,即先计算右侧的值,再更新左侧的参数
👉 类比:
蒙着眼睛下山走,总是朝着最陡的方向迈步。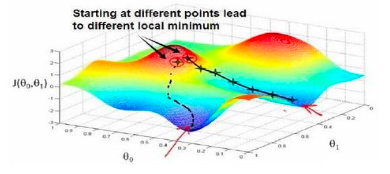
梯度下降的直观理解
梯度下降的核心在于学习率 α 和梯度方向的协调配合,可以用单参数示例来直观理解:
- 梯度的作用
- 当梯度为正时:θⱼ 减小(θⱼ := θⱼ − α × 正数),使代价函数下降
- 当梯度为负时:θⱼ 增大(θⱼ := θⱼ − α × 负数),使代价函数下降
- 当梯度为零时:θⱼ 停止更新,说明已到达最小值点
- 学习率 α 的影响
- α 太小:参数更新步长小,收敛缓慢,需要大量迭代才能到达最小值点
- α 太大:可能越过最小值点,导致代价函数发散,无法收敛
- 自适应收敛:随着参数逐渐接近最小值点,梯度逐渐减小。即使 α 固定,参数更新的幅度也会自动变小,最终实现收敛。
线性回归的梯度下降
将梯度下降算法与线性回归的代价函数相结合,即可得到线性回归的梯度下降求解方法。
计算偏导数
计算线性回归代价函数 $J(\theta_0, \theta_1)$ 的偏导数:
对 $\theta_0$ 的偏导数:
1 | ∂/∂θ₀ J(θ₀, θ₁) = (1/m) * Σⁱ₌₁ᵐ (h_θ(x⁽ⁱ⁾) - y⁽ⁱ⁾) |
对 $\theta_1$ 的偏导数:
1 | ∂/∂θ₁ J(θ₀, θ₁) = (1/m) * Σⁱ₌₁ᵐ (h_θ(x⁽ⁱ⁾) - y⁽ⁱ⁾) · x⁽ⁱ⁾ |
线性回归的梯度下降更新规则
将偏导数代入梯度下降公式,得到:
1 | θ₀ := θ₀ - α · (1/m) * Σⁱ₌₁ᵐ (h_θ(x⁽ⁱ⁾) - y⁽ⁱ⁾) |
算法流程总结
- 初始化参数 θ₀ 和 θ₁(例如,均设为 0)
- 计算所有训练样本的预测误差 h_θ(x⁽ⁱ⁾) - y⁽ⁱ⁾
- 代入更新规则,同时更新 θ₀ 和 θ₁
- 重复步骤 2-3,直到代价函数 J(θ₀, θ₁) 的变化小于某个阈值(收敛)
- 输出最优参数 θ₀ 和 θ₁,得到最终的假设函数
补充:批量梯度下降与正规方程
- 批量梯度下降:适合大规模数据集,通过迭代方式求解,需要选择学习率 α
- 正规方程:通过矩阵运算直接求解最优参数,无需迭代和学习率选择,但计算复杂度高,适用于小规模数据集